Catalogo di beni culturali
Un'applicazione web per catalogare opere, archivi, biblioteche e fotografie con le schede previste dagli standard nazionali. Nel 2026 ne ho guidato la migrazione a una tecnologia nuova.
A cosa serve e cosa può fare
Per enti e cooperative che catalogano patrimonio culturale con schede normate. Rientra nell'offerta di catalogazione che ETT presenta con la linea Scripta, insieme a digitalizzazione e conservazione.
- Compila schede secondo gli standard ICCD, con vocabolari controllati e campi obbligatori.
- Organizza il lavoro in campagne di catalogazione, con assegnazione e validazione delle schede.
- Gestisce ruoli diversi: catalogatori, coordinatori, archivisti.
- Esporta le schede consegnate.
- Si integra con gli altri standard di catalogazione e metadati usati dagli enti.
Il contesto
Enti e cooperative che catalogano il patrimonio culturale compilano schede normate: centinaia di campi, vocabolari controllati, regole di obbligatorietà. Le schede vanno validate, assegnate e consegnate. Il software è dell'azienda in cui lavoro come sviluppatore ed esiste dal 2006, scritto da molte persone.
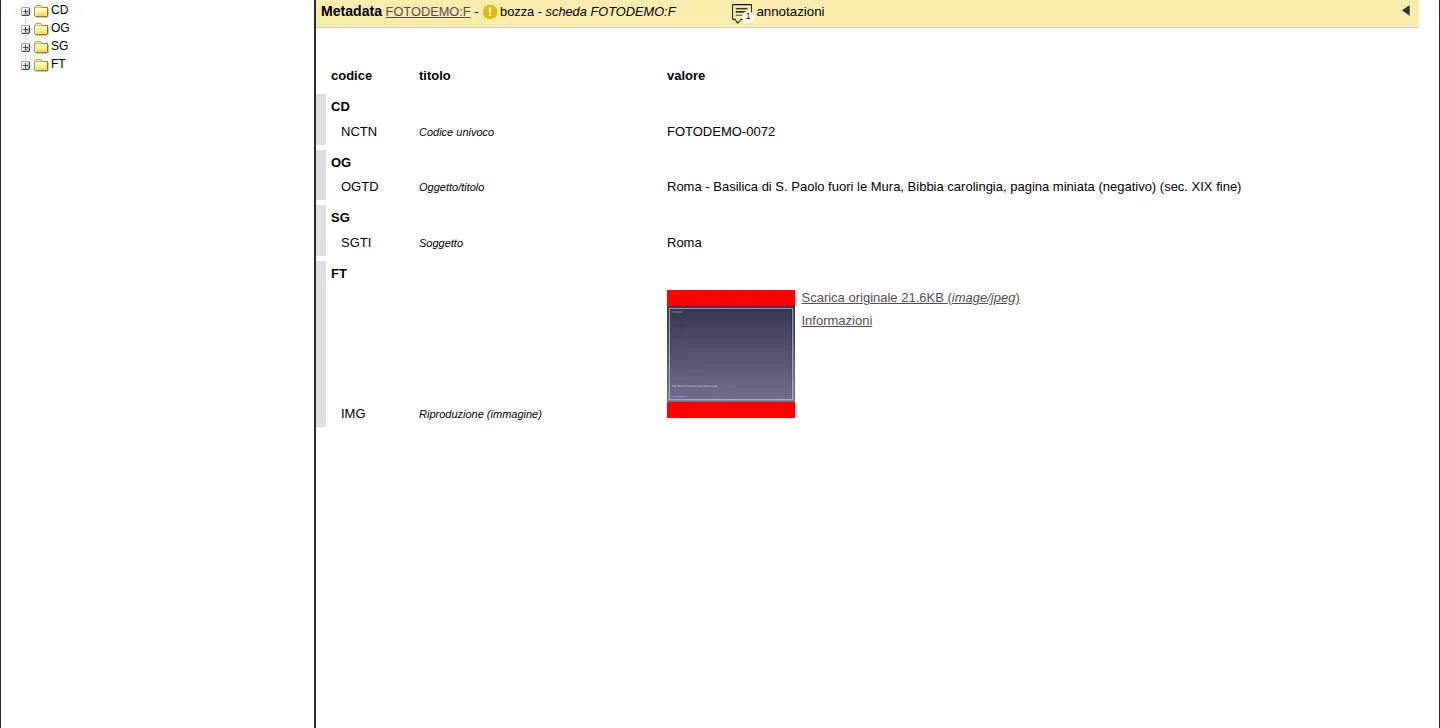
Il sistema vecchio aveva un'interfaccia del 2007 su una libreria che nessuno sviluppatore conosceva più e che ormai non funzionava sui browser moderni, e circa 57.000 righe di Python su Twisted senza specifiche scritte: il codice era l'unica specifica.
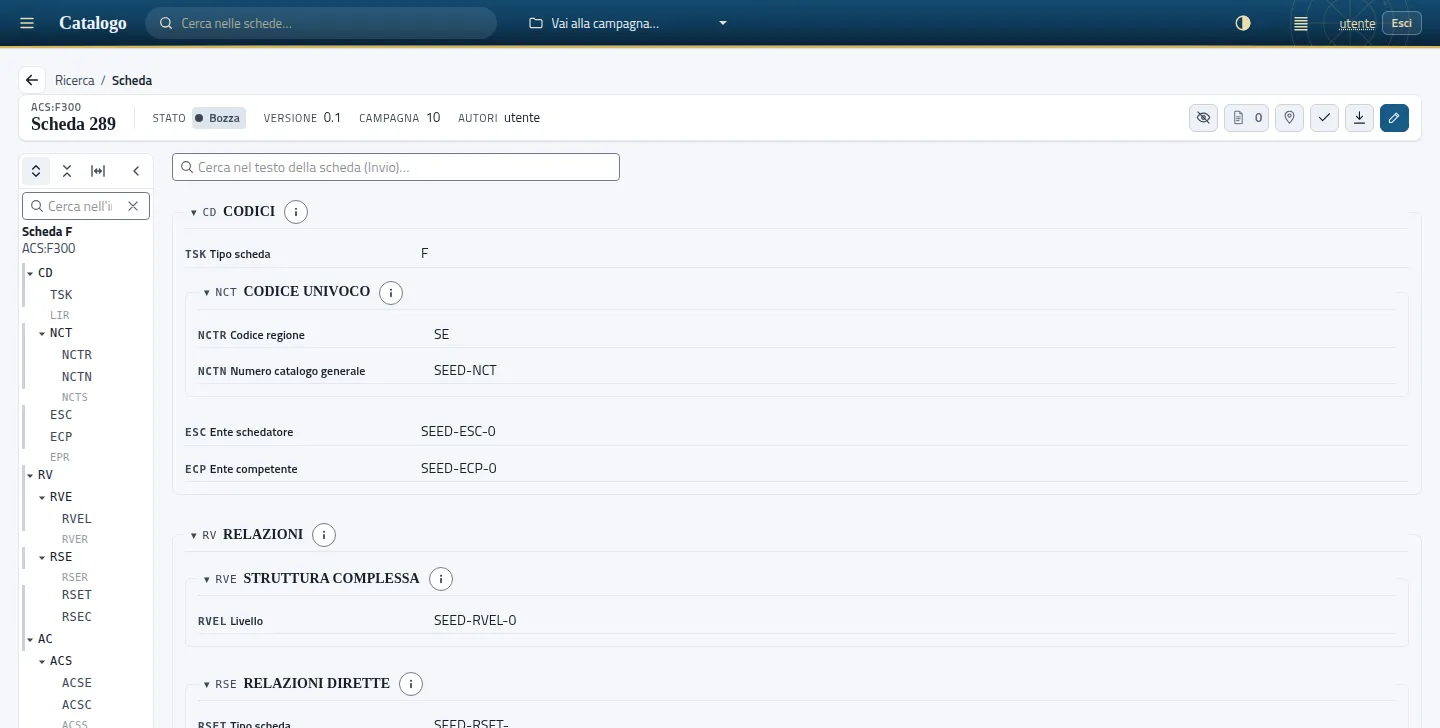
Prima e dopo: la scheda
La migrazione
Ho seguito la strategia «strangler fig»: invece di riscrivere tutto, ho sostituito il vecchio sistema un pezzo alla volta. Prima ho scritto una wiki del dominio e i test che fissano il comportamento attuale; poi ho portato il backend su FastAPI e l'interfaccia su Vue 3, finché nel luglio 2026 Twisted ed ExtJS sono usciti dal programma in esecuzione. Le regole di catalogazione vecchie di vent'anni sono state mantenute e coperte da test, non reinventate.
Il sistema oggi (dati di esempio)
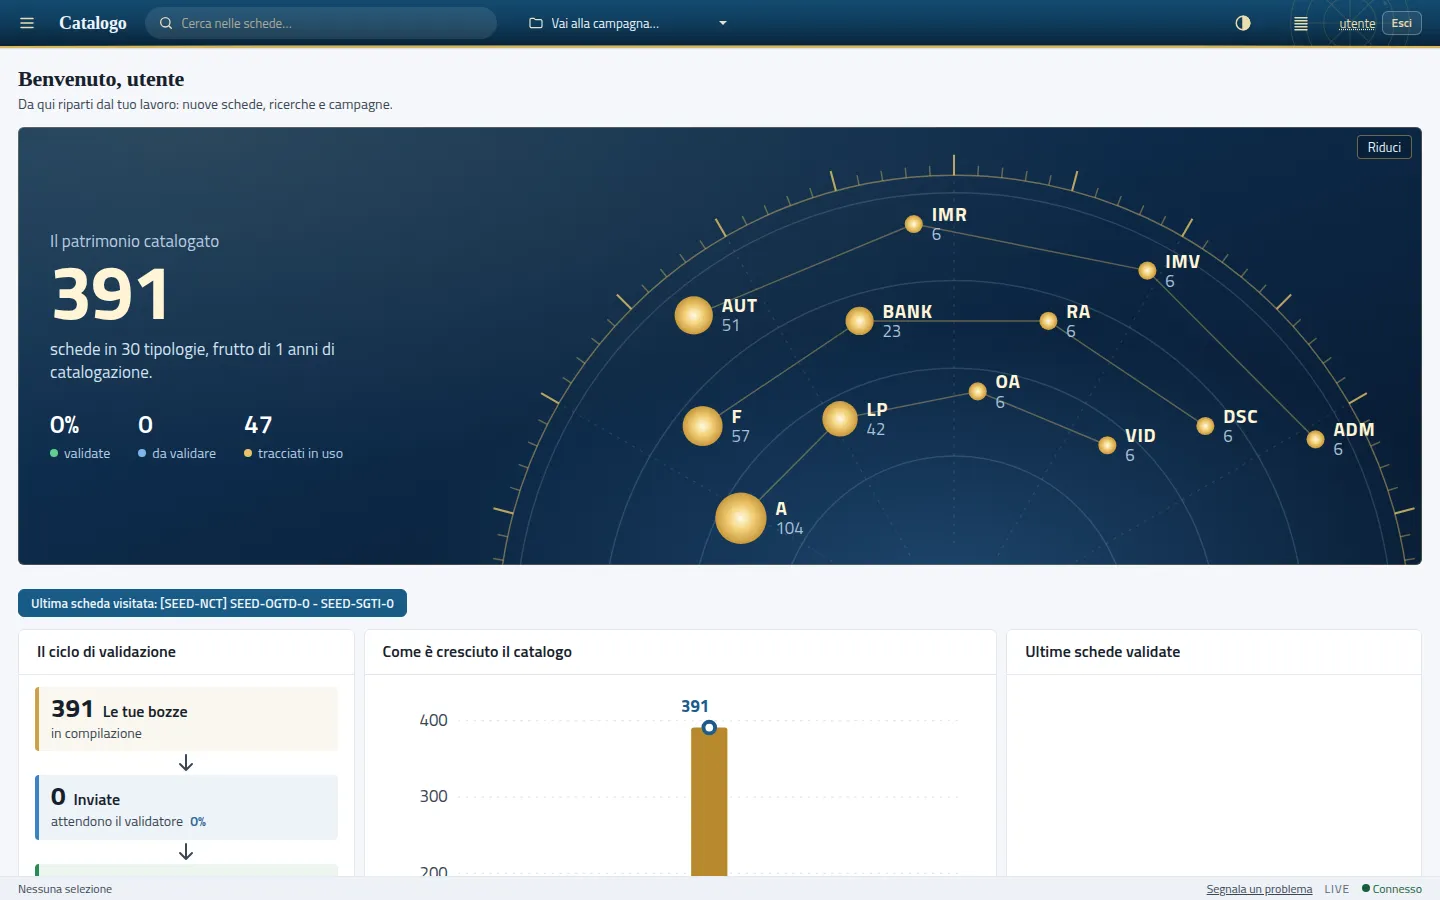
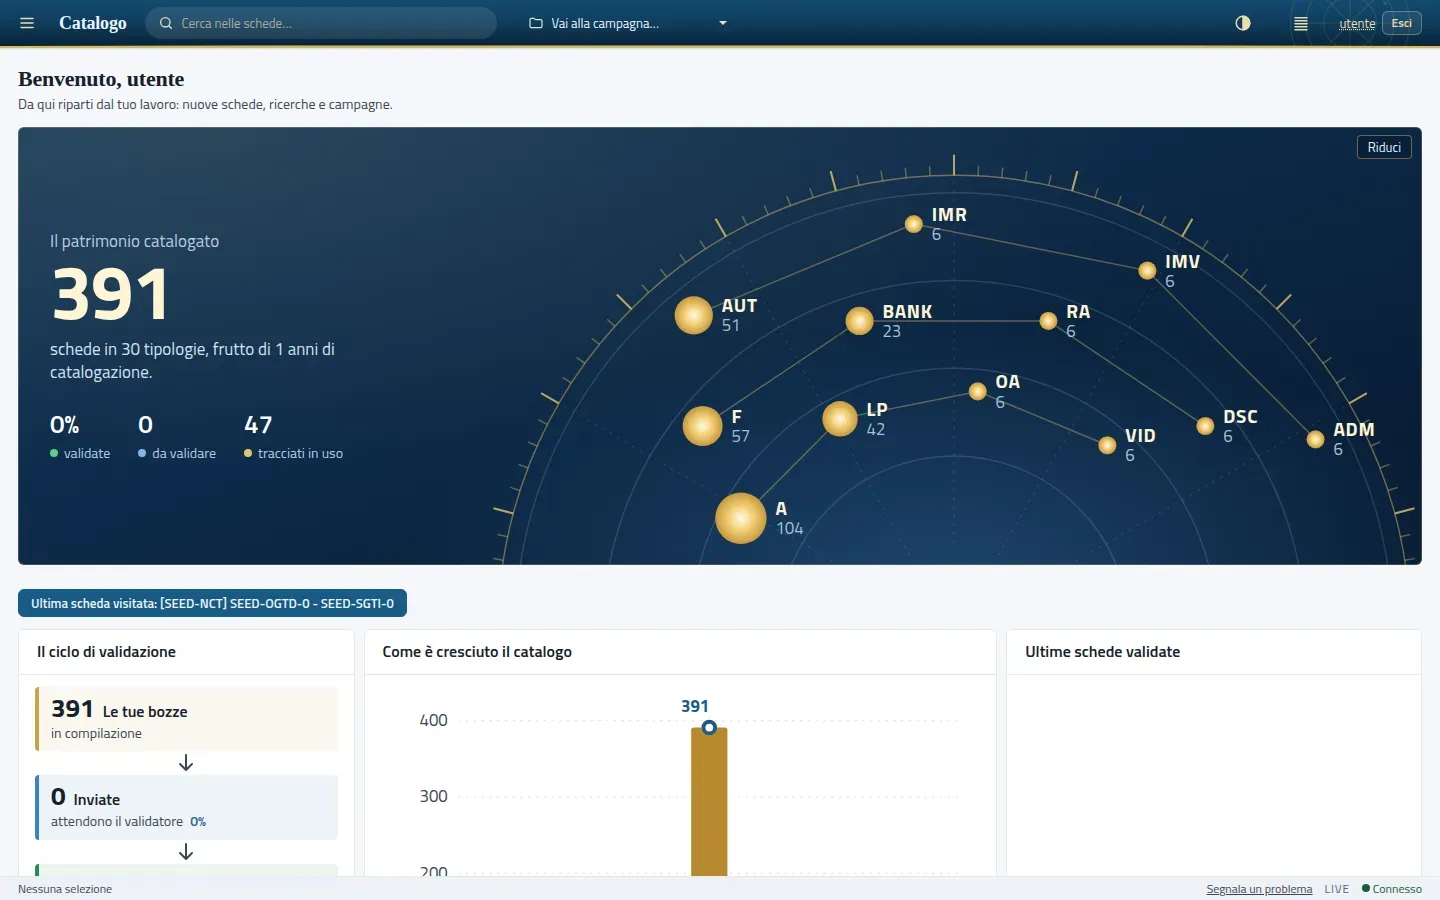
Pagina iniziale del catalogo con il patrimonio catalogato per tipologia di scheda, dati di esempio
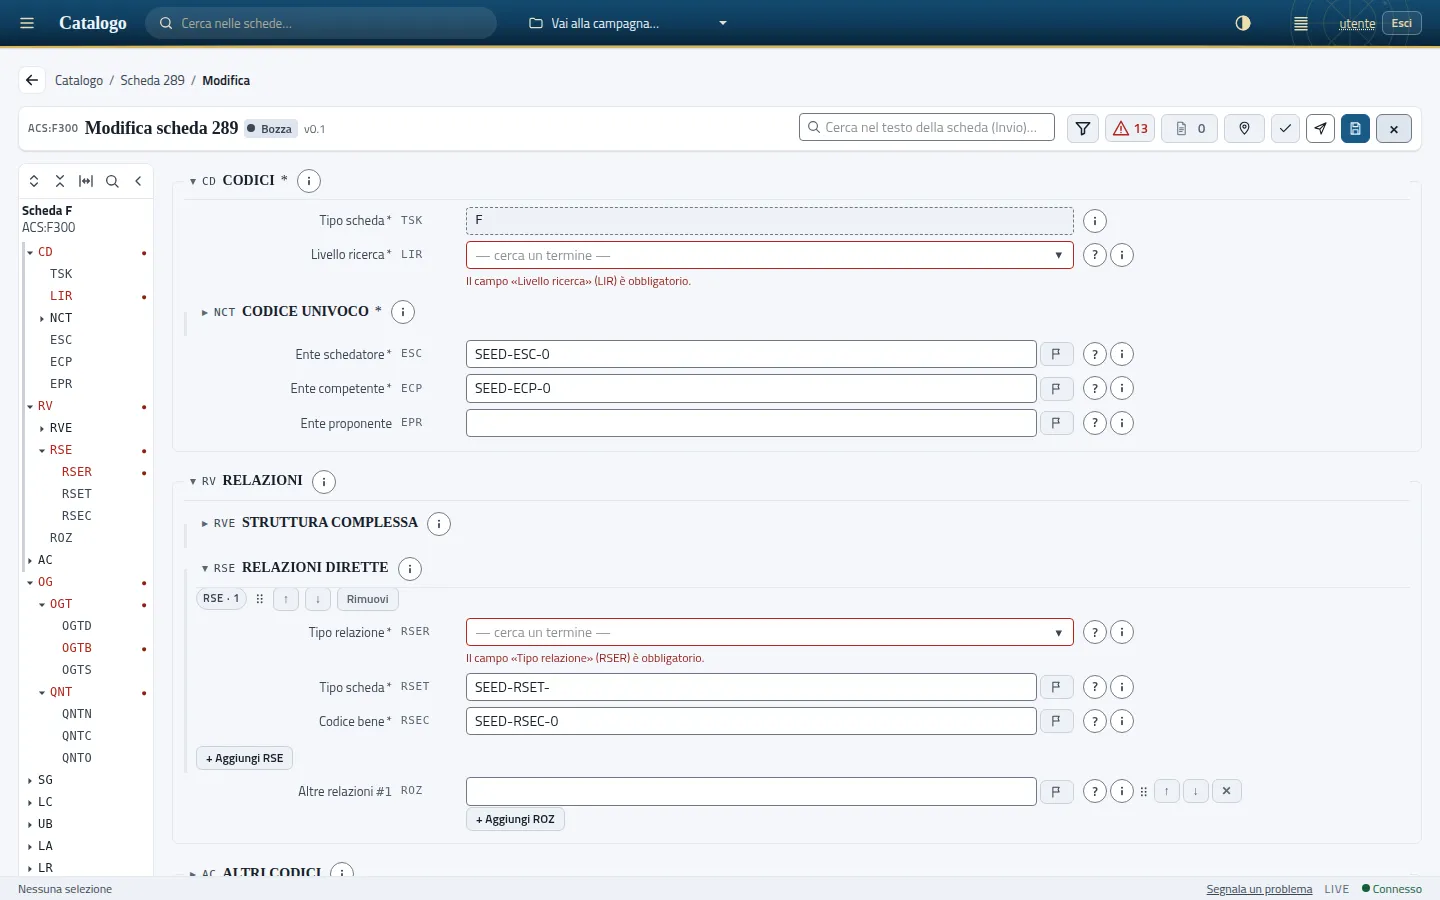
Scheda in modifica con campi obbligatori, vocabolari controllati e contatore degli errori
Alcune scelte tecniche
- Cinque livelli (dominio, repository, servizi, schemi, API) con regole di import controllate da un programma, e 14 decisioni di architettura scritte.
- Il contenuto di una scheda è un valore immutabile; il contratto JSON tra backend e interfaccia è generato dall'OpenAPI.
- Un database per ogni cliente, con i vocabolari di riferimento condivisi.
- Un unico importatore per formati diversi (EAD, ArCo, schede digitalizzate) che riconosce i doppioni: 56.910 schede importate in circa 45 minuti, 28 millisecondi a scheda.
Cosa è mio e cosa no
Il programma ha più di 7.000 commit dal 2006, quasi tutti di altri colleghi. Miei sono due piccole correzioni a marzo 2026 e, da giugno, la migrazione: circa 1.600 commit, tra piani, decisioni di architettura, test, backend e interfaccia. Non ho scritto il software, ho ereditato e portato avanti un codice che esisteva già.
Ho lavorato con un agente AI (Claude Code): dalla migrazione compare come coautore in circa sei commit su dieci. Io ho fissato i piani e le decisioni e ho verificato i risultati; il codice lo hanno scritto in gran parte gli agenti.
Limiti e stato
È in uso e in sviluppo, ma non è pubblico e non c'è una demo. Il numero di versione dichiarato e le etichette del repository non sono allineati, e alcune funzioni descritte nei documenti sono studi realizzati solo in parte. Due dei tracciati sono rimasti fuori dalla prima fase.
Stack
Python · FastAPI · SQLAlchemy · PostgreSQL/PostGIS · Pydantic · Celery · Redis · Vue 3 · TypeScript · Pinia · OpenLayers · Docker · pytest · Playwright